این مدیران اجرایی معتقدند هوش مصنوعی صوتی هنوز لحظه ChatGPT خود را تجربه نکرده است
هوشهای مصنوعی صوتی اغلب نکات مهم موردنیاز لایه زمینه را از قلم میاندازند و باعث از کار افتادن کل خط پردازش میشوند.
این ایده که صدا رابط کاربری بزرگ بعدی خواهد بود، با شتاب زیادی روبهرو شده است. سرمایهگذاران میلیاردها دلار به استارتاپهای هوش مصنوعی صوتی تزریق میکنند؛ استارتاپهایی که از سازندگان مدل گرفته تا ارائهدهندگان خدمات مشتری سازمانی، و از ابزارهای یادداشتبرداری در جلسه تا ابزارهای دیکته مبتنی بر هوش مصنوعی را دربرمیگیرند.
هر هفته مدل یا ابزار تازهای عرضه میشود که ادعا میکند صدایی انسانی دارد و مانند انسان گفتوگو میکند. بااینحال، در عمل ممکن است چنین نباشد. بهگفته Shawn Wen، مدیر ارشد فناوری پلتفرم هوش مصنوعی صوتی سازمانی PolyAI، با وجود عرضه مدلهای تمامدوطرفه — که میتوانند همزمان با گوشدادن به شما صحبت کنند — هوش مصنوعی صوتی هنوز به «لحظه ChatGPT» خود نرسیده است.
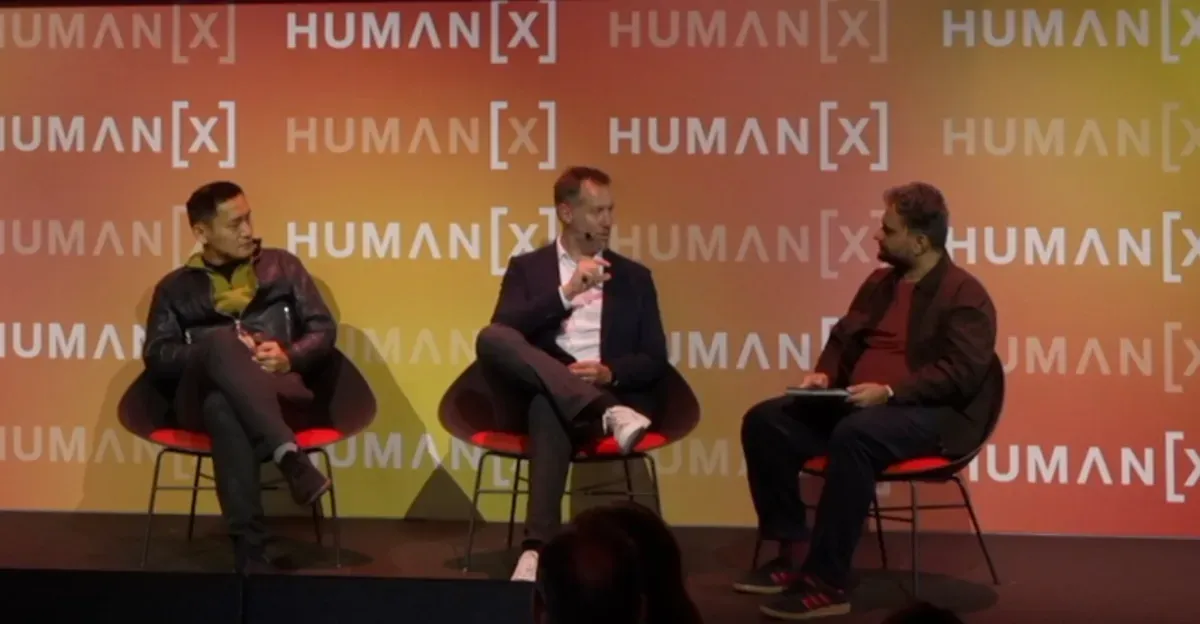
او ماه گذشته در کنفرانس HumanX و روی صحنه به من گفت: «به نقطه عطف توسعه مدلهای تمامدوطرفه رسیدهایم. چالش بعدی این است که استدلال را بسیار سریع کنیم تا مدلها بتوانند پاسخها را سریع پیدا کنند و گفتوگو طبیعی به نظر برسد.»
او همچنین گفت عاملهای هوش مصنوعی در خدمات مشتری نباید رباتیک به نظر برسند و باید آنقدر اعتماد تماسگیرندگان را جلب کنند که مطمئن شوند این عاملها میتوانند مشکلاتشان را حل کنند.
او گفت: «فکر میکنم مرحله بعد کمی متفاوت خواهد بود؛ چون وقتی کیفیت صدا بهاندازه کافی خوب باشد و مشتری حاضر شود در دو یا سه نوبت نخست با آنها تعامل کند، اعتمادش جلب میشود و بهمرور احساس میکند احتمالاً نیازی نیست با یک انسان صحبت کند، اگر عامل بتواند مشکلم را حل کند.»
Alex Gay، مدیر ارشد بازاریابی ابزار یادداشتبرداری جلسه Otter، معتقد است شناسایی گوینده، تشخیص نیت و تبدیل گفتار به متن با استفاده از دانش سازمانی، گامی کلیدی برای فراهمکردن امکان خودکارسازی است. این شرکت همچنین روی دوقلوهای دیجیتال کار میکند که میتوانند نماینده افراد در جلسات باشند. او گفت در این فناوری، ضروری است صدای خروجی همان بار عاطفی گفتوگو با یک انسان در جلسه را منتقل کند.
Gay گفت: «اگر به جلسههایی که همین حالا در آنها شرکت میکنید فکر کنید، بهترین گفتوگوها آنهایی هستند که در آنها میتوانید بحث و گفتوگوهای راهبردی داشته باشید و احساس کنید رابطهای زیربنای گفتوگوست. اگر نتوانید چنین تجربهای را با یک آواتار داشته باشید، آن فقط یک چتبات پرسشوپاسخ است.»
با وجود پیشرفت مدلهای هوش مصنوعی صوتی، دستیارهای هوش مصنوعی اغلب منظور کاربران را درک نمیکنند یا ابزار یادداشتبرداری جلسه، متن پیادهشده یا خلاصهای نادرست ارائه میدهد.
Wen معتقد است مدلهای ASR (تشخیص خودکار گفتار) اغلب کلمات کلیدی مهم را تشخیص نمیدهند و همین مسئله در ثبت کل بافت گفتوگو مشکل ایجاد میکند.
Gay از Otter نیز با این نظر موافق بود و افزود که این شرکت همچنان برای بهبود پیادهسازی گفتار به متن تلاش میکند. او همچنین گفت زبان یکی از حوزههایی است که مدلهای صوتی باید در آن پیشرفت کنند.
او گفت: «برای Otter، پیادهسازی گفتار به متن هیچوقت هدف نهایی نبود؛ بلکه لایهای بود که میتوانستیم با تکیه بر آن، بخشی از دستاوردهای بهرهوری را ایجاد کنیم. اما اگر دقت متن اولیه بهاندازه موردنیازتان نباشد، همه اقدامهای بعدیتان با مشکل روبهرو میشوند. و بهمحض اینکه سیستم اقدامی نادرست انجام دهد، اعتماد شما به پلتفرم از بین میرود. برای ما بهبود مداوم مدل ASR ضروری است، چون همه پیامدهای بعدی آن چشمگیرند.»
ابزارهای صوتی جدید مسئله شفافیت را نیز مطرح میکنند. ابزارها باید به مشتریان اعلام کنند که صدایشان ضبط میشود یا با هوش مصنوعی صحبت میکنند. Otter گفت میخواهد اعتماد افرادی را که در جلسه حضور دارند جلب کند؛ بنابراین حتی وقتی ربات در جلسه حضور ندارد، میخواهد روشهایی مانند اطلاعدادن به همه افراد در چت درباره ضبط جلسه را به کار بگیرد. Wen از PolyAI نیز گفت مهم است که در تماسهای سازمانی مشخص شود افراد با یک هوش مصنوعی صحبت میکنند.
اخبار مرتبط از TechCrunch AI

چه کسی میتواند جایگزین جنسن هوانگ شود؟ فهرستی کاملاً غیرعلمی از جانشینان احتمالی
انویدیا برنامهای برای جانشینی مدیرعامل ندارد و مدیرعاملش هم به دردسر افتاده است؛ بنابراین، فهرستی کوتاه از گزینهها تهیه کردهایم.

سهام انویدیا در پی گزارشها درباره تدارک هیئتمدیره برای برکناری جنسن هوانگ، مدیرعامل شرکت، افت کرد.
هیئتمدیره Nvidia ممکن است از شامگاه چهارشنبه درباره برکناری بنیانگذار این شرکت و مدیرعاملی که ۳۳ سال در این سمت بوده است، تصمیم بگیرد.

خط زمانیِ رسواییِ فزایندهٔ جنسن هوانگ
این ماجرا میتواند برای امنیت ملی پیامدهایی داشته باشد؛ آن هم در شرایطی که آمریکا و چین برای توسعه پیشرفتهترین زیرساخت هوش مصنوعی با یکدیگر رقابت میکنند.
