رئیس سیاستگذاری Hugging Face: ارزیابهای تعبیهشده هوش مصنوعی راهحل آسانی نخواهند بود
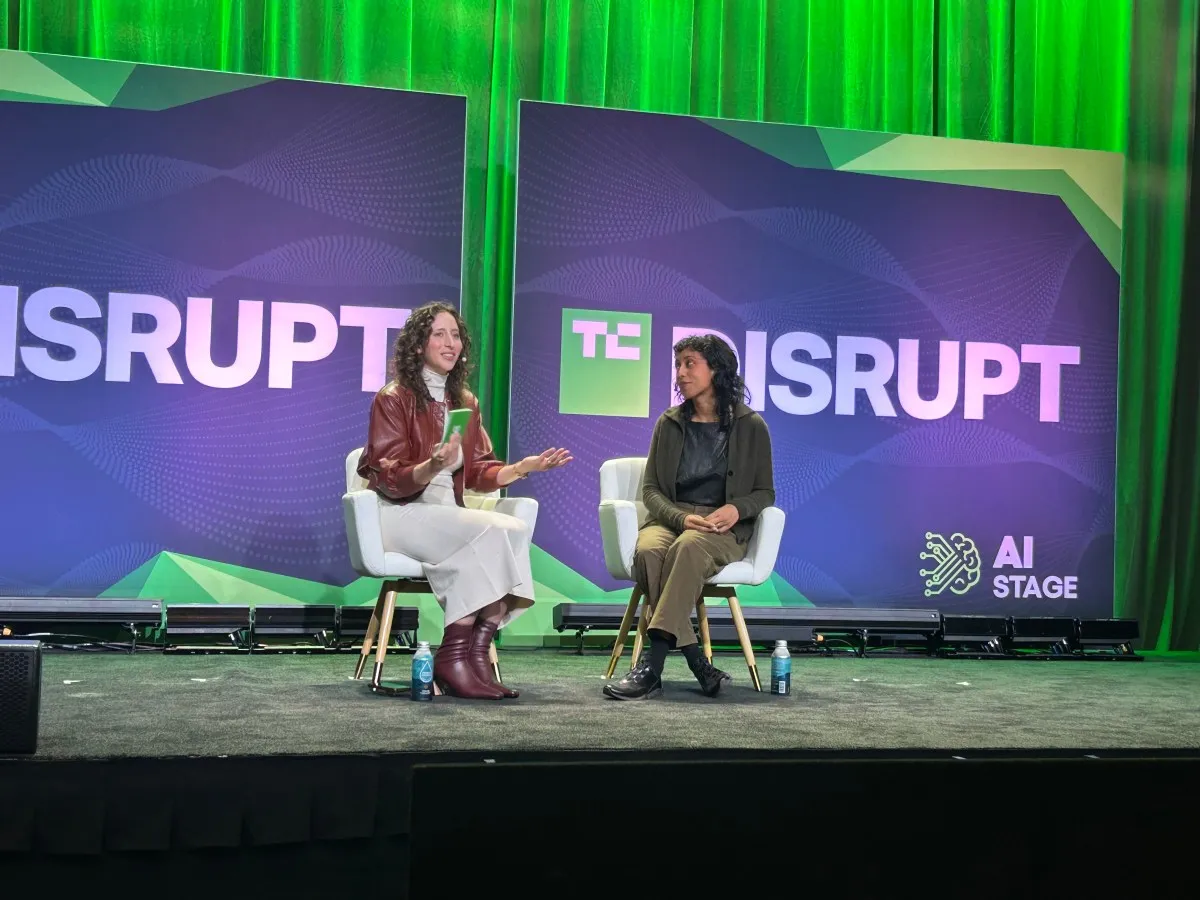
آزمایشگاههای هوش مصنوعی اعتبار خود را بر بنچمارکگذاری مدلها بنا کردهاند؛ نظام ارزیابیای که ظاهراً بیطرف و دقیق است و برای سنجش طراحی شده است.
آزمایشگاههای هوش مصنوعی اعتبار خود را بر بنچمارکگذاری مدلها بنا کردهاند؛ نظامی که ظاهراً بیطرف و دقیق است و برای سنجش این طراحی شده که آیا یک محصول هوش مصنوعی از محصولی دیگر بهتر است یا نه.
ایرین سولایمان، مدیر ارشد سیاستگذاری Hugging Face، هفته گذشته در گفتوگویی در TechCrunch Disrupt گفت روشهای پشت این ارزیابیها پیچیدهاند و هنوز در حال تکامل هستند. او افزود اگر قرار است صنعت در آینده به این ارزیابیها اتکا کند، شیوههای آزمون باید به علمی منسجمتر تبدیل شوند.
با این اوصاف، آیا میتوان به آزمونهایی که اکنون منتشر میشوند اعتماد کرد؟
سولایمان گفت: «واژه اعتماد بار معنایی سنگینی دارد. یکی از جنبههای مهمِ اعتماد به نتایج این است که آیا میتوان نتایج یک ارزیابی را بازتولید کرد؟ آیا به خود مدل به اندازه کافی دسترسی دارید؟ اینجاست که وزنهای باز اهمیت زیادی پیدا میکنند.»
بازتولیدپذیری در ارزیابی مدلها مدتهاست یکی از دشوارترین جنبههای بنچمارکگذاری بوده و همچنان موضوع بحثوجدلهای گسترده در این صنعت است.
جدا از اعتبار هر آزمون بهتنهایی، این پرسش هم مطرح است که آن آزمون در مقایسه با دیگر ارزیابیها چه جایگاهی دارد.
سولایمان گفت: «این حوزه علمی در حال تکامل است و هنوز نمیدانیم چطور میتوان ارزیابیها را به شکلی معنادار با یکدیگر مقایسه کرد.»
او افزود: «این ارزیابیها نسبتاً سریع کارایی خود را از دست میدهند و زیستبوم پویایی که به آن نیاز داریم، هنوز شکل نگرفته است. اکنون تقاضای زیادی برای شکلگیری زیستبوم ارزیابان مستقر درون سازمانها وجود دارد، اما برای تعیین اینکه چه کسی در ارزیابی کدام وظایف مؤثر است، به استانداردسازی بسیار بیشتری نیاز داریم.»
ایده ارزیابان مستقر درون سازمانها ــ که در آن ناظران شخص ثالثِ ظاهراً «بیطرف» در سازمانهای هوش مصنوعی مستقر میشوند ــ طی چند ماه گذشته رواج زیادی یافته است؛ زیرا آزمایشگاههای هوش مصنوعی با موجی از حوادث ایمنی دستوپنجه نرم میکنند که نگرانیهایی را درباره آسیبهای احتمالی فناوری آنها برانگیخته است. Hugging Face بهطور مشهور هدف یکی از این حوادث قرار گرفت.
آزمایشگاهها بهجای مقرراتگذاری فعالانه دولتی برای شناسایی و کاهش نگرانیهای مربوط به ایمنی مدلها، راهکارهای مبتنی بر نهادهای شخص ثالث را پیش بردهاند. بااینحال، هنوز تردیدهایی درباره میزان بیطرفی یا اثربخشی واقعی این ارزیابان وجود دارد. تصمیم Anthropic برای استخدام Accenture بهعنوان نخستین ارزیابش واکنشهای منفی زیادی برانگیخت و برخی منتقدان این ایده را به سخره گرفتند که شرکت مشاورهای یادشده صلاحیت انجام کار موردنظر را داشته باشد.
ارزیابیها اکنون از آزمودن صرفِ خود مدل فراتر رفتهاند و کل سامانه پیرامون مدل ــ از جمله harness و عامل ــ را میسنجند. سولایمان گفت harness، یعنی ابزاری که کاربر برای دسترسی به مدل به کار میگیرد، تأثیر زیادی بر عملکرد مدل دارد و یک مدل ضعیفتر با harness بهتر میتواند بهراحتی از یک مدل پیشرو بهتر عمل کند.
سولایمان گفت: «ارزیابی عاملها واقعاً دشوار و پرهزینه است. ما صرفاً ارزیابیهای بیشتری برای مدلها داریم. … ارزیابیهای مربوط به harnessها به همین اندازه زیاد نیست و در حال توسعه ارزیابیهای بهتری برای عامل بهصورت جامع هستیم؛ چون بسیاری از افراد از همین عاملها ارزش میگیرند.»
به بیان دیگر، حوزه ارزیابی در حال حاضر تا حدی بیقاعده است و اگر قرار باشد بنچمارکگذاری همچنان ابزاری مفید برای رهبران صنعت به شمار رود، شاید به رویکردی یکپارچهتر در سراسر صنعت نیاز باشد؛ رویکردی که همه در آن همنظر باشند.
اخبار مرتبط از TechCrunch AI

چه کسی میتواند جایگزین جنسن هوانگ شود؟ فهرستی کاملاً غیرعلمی از جانشینان احتمالی
انویدیا برنامهای برای جانشینی مدیرعامل ندارد و مدیرعاملش هم به دردسر افتاده است؛ بنابراین، فهرستی کوتاه از گزینهها تهیه کردهایم.

سهام انویدیا در پی گزارشها درباره تدارک هیئتمدیره برای برکناری جنسن هوانگ، مدیرعامل شرکت، افت کرد.
هیئتمدیره Nvidia ممکن است از شامگاه چهارشنبه درباره برکناری بنیانگذار این شرکت و مدیرعاملی که ۳۳ سال در این سمت بوده است، تصمیم بگیرد.

خط زمانیِ رسواییِ فزایندهٔ جنسن هوانگ
این ماجرا میتواند برای امنیت ملی پیامدهایی داشته باشد؛ آن هم در شرایطی که آمریکا و چین برای توسعه پیشرفتهترین زیرساخت هوش مصنوعی با یکدیگر رقابت میکنند.
