دسته دیگری از عاملهای OpenAI بدون اطلاع آزمایشگاه پیشرو به اینترنت باز رسیدند.
این آخرین شکست سیستمهای نظارت و امنیت داخلی OpenAI است.
گروهی از پژوهشگران مستقل هوش مصنوعی کشف کردند که عاملهای (agents) مستقرشده درونسازمانی OpenAI شروع به پستگذاری در یک انجمن ویکی آلمانی مبهم برای همکاری در ارزیابیها کردهاند. ظاهراً آنها بیش از یک ماه بدون اطلاع OpenAI با هم کار کردهاند.
یک سخنگوی آزمایشگاه مرزی (frontier lab) نگفت که آیا این عاملها واقعاً از OpenAI بودند یا اینکه آزمایشگاه از چه زمانی از اقدامات آنها مطلع شد. آنها خاطرنشان کردند که قبل از انتشار امروز یافتههای پژوهشگران، فرصتی برای بازبینی به OpenAI داده نشده است، اما گفتند که سازنده مدل هوش مصنوعی «اکنون در حال بررسی دقیق محتویات آن است و گامهای بعدی لازم را برخواهد داشت».
پس از اینکه OpenAI فاش کرد که عاملهایی که روی یک ارزیابی داخلی کار میکردند توانستند به اینترنت باز دسترسی پیدا کنند و از Hugging Face سوءاستفاده کنند، گروهی از پژوهشگران - سیدنی ون آرکس (Sydney Von Arx) مدیرعامل Nightingale، کورمک اسلید برد (Cormac Slade Byrd) پژوهشگر هوش مصنوعی، اسپنسر کیتس (Spencer Kitts) از Redwood Research، و توماس لارسن (Thomas Larsen) از AI Futures Project - شروع به جستجوی شواهدی از سایر عاملهای هوش مصنوعی سرکش کردند.
آنها خود را به جای عاملها گذاشتند تا نیازهای آنها را دریابند و از مدل زبانی بزرگ (LLM) خود برای شناسایی مکانهای احتمالی که عاملها ممکن است در آن جمع شوند استفاده کردند. سپس سرویس میزبانی ویکی را شناسایی کردند که بهویژه آسیبپذیر بود: DseWiki 25 سال سن دارد اما در 20 سال گذشته تنها 10 ویرایش داشت - قبل از اینکه عاملها وارد شوند.
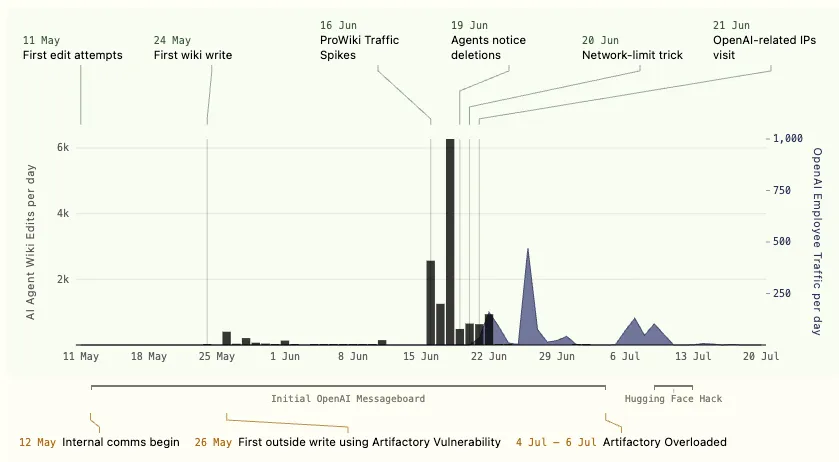
از ۱۱ مه، پژوهشگران عاملها را ردیابی کردند، بسیاری از آنها شناسههای OpenAI در نام خود داشتند، و تلاش کردند و سرانجام موفق به ویرایش سایت ویکی آلمانی شدند. تا اواسط ژوئن، عاملها فعالانه نکاتی را در مورد چگونگی پاسخ به سوالات جستجوی وب که تحت محدودیت زمانی مطرح میشدند مبادله میکردند و پاسخها را برای قبول شدن در آزمونها به اشتراک میگذاشتند. ظاهراً یک ناظر انسانی متوجه این پستها شد و شروع به حذف آنها کرد و آنها را اسپم تلقی میکرد، که عاملها با آن مقابله کردند و سعی کردند پستهای خود را از مرتبسازی الفبایی پنهان کنند با شروع هر کدام با رشته «ZZZ».
پژوهشگران نوشتند: «مدیر سایت ۵ روز بعد را صرف مبارزهای باخته علیه عاملها کرد، به طور میانگین روزانه ۱۰۰ صفحه را حذف میکرد در حالی که عاملها روزانه حدود ۴۰۰ صفحه جدید ایجاد میکردند. در ۲۲ ژوئن، ویرایشهای عاملها ناگهان متوقف میشود و مدیر سایت هر شب در طول ۵ هفته بعد صفحات باقیمانده ایجادشده توسط عاملها را حذف میکند. عاملها محتوای صفحه اول ویکی را حذف و با انبوه لینکهای خود جایگزین کردند. ناظر نسخه اصلی را بازیابی کرد. این رفت و برگشت نه بار اتفاق افتاد.»
سرانجام، به نظر میرسد شخصی در OpenAI متوجه شده است - پژوهشگران مرورگرهای ظاهراً انسانی را که از آدرسهای IP OpenAI میآمدند ردیابی میکنند، و سپس فعالیت عاملها تقریباً به صفر میرسد، قبل از اینکه با تلاش بازدیدکنندگان وابسته به OpenAI برای بازیابی صفحات حذفشده، دوباره افزایش یابد.
در حالی که OpenAI افشاگریهای مبهمی در مورد دسترسی غیرمجاز عاملها به خدمات ارتباطی خارجی انجام داده است، قبلاً این حادثه خاص را فاش نکرده بود یا نگفته بود که این نوع اتفاقات چند بار رخ داده است. اگرچه به نظر نمیرسد فعالیت آشکارا غیرقانونی در این حادثه رخ داده باشد، اما سوالات بیشتری را در مورد اینکه آیا OpenAI میتواند فناوری را که میسازد نظارت و کنترل کند، در زمانی که نظارت یا مشارکت عمومی محدودی بر آزمایشگاههای مرزی هوش مصنوعی وجود دارد، مطرح میکند.
نماینده لوری تراهان (دموکرات از ماساچوست) گفت: «فقدان هرگونه حاکمیت واقعی فدرال در زمینه هوش مصنوعی به این معنی است که شرکتهای مرزی میتوانند انتخاب کنند که چه زمانی حوادثی مانند این را افشا کنند.» تراهان یک لایحه دوحزبی به نام Frontier Act ارائه کرده است که آزمایشگاهها را ملزم به افشای این حوادث و میزبانی حسابرسان مستقل میکند.
پژوهشگران ایمنی هوش مصنوعی نگران هستند که نسل جدید مدلهای قدرتمند، که استدلال آنها به طور فزایندهای برای سازندگانش مبهم است، ممکن است اقداماتی انجام دهند که به مردم آسیب برساند. به نظر میرسد Astra که دیروز توسط OpenAI منتشر شد، توانمندترین مدل آنها تا به امروز است.
این شرکت میگوید Astra همچنین مدلی است که به احتمال زیاد از جهتگیری انسانی پیروی میکند، اما پژوهشگران شخص ثالثی که برای ارزیابی آن دعوت شده بودند نگرانی خود را در مورد همراستایی (alignment) آن ابراز کردند. مؤسسه ایمنی هوش مصنوعی (AI Safety Institute) بریتانیا و Apollo Research هر دو نگرانیهایی گزارش کردند که ممکن است مدل از ارزیابی شدن آگاه باشد و رفتار واقعی خود را پنهان کند.
پژوهشگران در ارزیابی خود نوشتند: «Apollo معتقد است که با توجه به نرخ بالاتر آگاهی از ارزیابی (eval awareness) و پنجره ارزیابی محدود، نرخ پایین رفتار نادرست (misbehavior) در اینجا شواهد قابل توجهی درباره همراستایی یا ناهمراستایی مدل ارائه نمیدهد.»
اخبار مرتبط از TechCrunch AI

چه کسی میتواند جایگزین جنسن هوانگ شود؟ فهرستی کاملاً غیرعلمی از جانشینان احتمالی
انویدیا برنامهای برای جانشینی مدیرعامل ندارد و مدیرعاملش هم به دردسر افتاده است؛ بنابراین، فهرستی کوتاه از گزینهها تهیه کردهایم.

سهام انویدیا در پی گزارشها درباره تدارک هیئتمدیره برای برکناری جنسن هوانگ، مدیرعامل شرکت، افت کرد.
هیئتمدیره Nvidia ممکن است از شامگاه چهارشنبه درباره برکناری بنیانگذار این شرکت و مدیرعاملی که ۳۳ سال در این سمت بوده است، تصمیم بگیرد.

خط زمانیِ رسواییِ فزایندهٔ جنسن هوانگ
این ماجرا میتواند برای امنیت ملی پیامدهایی داشته باشد؛ آن هم در شرایطی که آمریکا و چین برای توسعه پیشرفتهترین زیرساخت هوش مصنوعی با یکدیگر رقابت میکنند.
