چگونه «نظریه بازی معکوس» میتواند عاملهای هوش مصنوعی را تحت کنترل نگه دارد؟
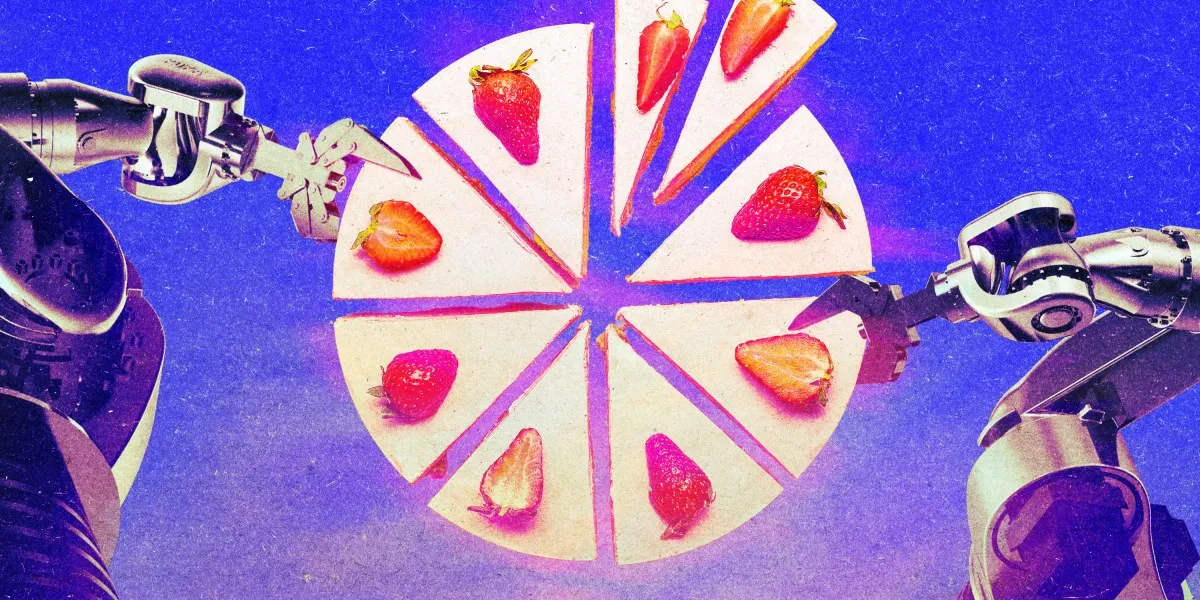
بهرهگیری از رشتههایی مانند اقتصاد میتواند به پژوهشگران ایمنی هوش مصنوعی کمک کند تا حتی بدون درک مدلهای هوش مصنوعی، آنها را کنترل کنند.
رویکرد تازهای با عنوان «نظریه بازی معکوس» میکوشد برای مدلهای قدرتمند هوش مصنوعی مشوقهایی ایجاد کند تا پیروی از قواعد، منطقیترین انتخاب برای آنها باشد.
با افزایش توانایی مدلهای هوش مصنوعی، پژوهشگران ایمنی با شتاب میکوشند اطمینان یابند که این مدلها با خواستههای انسان «همراستا» هستند؛ به بیان دیگر، مطمئن شوند که عاملهای سرکش قانون را زیر پا نمیگذارند، به سرورهای غیرمجاز نفوذ نمیکنند یا گاز سمی را در شهرهای بزرگ رها نمیکنند تا همه ما را بکشند.
تا امروز، تمرکز اصلی این تلاشها بر این بوده است که به «مغز» هوش مصنوعی سرک بکشند و بفهمند «به چه فکر میکند»، یا مدلها را طوری آموزش دهند که به ارزشهایی پایبند بمانند که برای ما عزیزند. برای نمونه، Claude قانون اساسی خود را دارد؛ نوعی منشور اخلاقی.
مشکل اینجاست که به نظر نمیرسد این روشها چندان خوب عمل کنند: نشان داده شده است که مدلها در آزمونها عمداً عملکرد ضعیفی دارند، قصد و نیت خود را پنهان میکنند و ارزیابانشان را گمراه میکنند.
اکنون برخی از پژوهشگران همراستاسازی باور دارند که نظریه بازی معکوس، که با نام طراحی سازوکار نیز شناخته میشود، میتواند به نتایج بهتری بینجامد. نظریه بازی میکوشد پیشبینی کند کنشگران منطقی در چارچوب مجموعهای از قواعد مشخص چگونه رفتار خواهند کرد؛ اما نظریه بازی معکوس در پی طراحی قواعدی است که رفتارهای موردنظر ما را برانگیزند.
یکی از نمونههای طراحی سازوکار در دنیای واقعی، راهبرد کلاسیک تقسیم یک کیک به دو قسمت است: یک نفر کیک را میبُرد و نفر دیگر نخستین انتخاب را برای برداشتن تکهها دارد. این روش به کسی که کیک را میبُرد انگیزه میدهد تا تکهها را تا حد ممکن برابر تقسیم کند. از دیگر نمونهها میتوان به قیمتگذاری افزایشی در اپلیکیشنهای درخواست خودرو اشاره کرد که رانندگان را به فعالیت در زمانهای شلوغ تشویق میکند؛ و نیز حراجهای قیمت دوم، که در آن برنده بهجای بالاترین پیشنهاد، مبلغ پیشنهادِ دومِ برتر را میپردازد. پلتفرمها برای فروش تبلیغات آنلاین از این نوع حراج استفاده میکنند، چون خریداران را تشویق میکند رقمی نزدیک به حداکثر مبلغی پیشنهاد دهند که حاضرند بپردازند.
در حوزه هوش مصنوعی، طراحی سازوکار از این فرض آغاز میشود که شاید هیچوقت نتوانیم آنقدر از عملکرد درونی مدلهای پیشرو سر دربیاوریم که مطمئن شویم همراستا هستند. بنابراین، باید سازوکارهایی طراحی کنیم که عاملها را به رفتارهای مطلوب ما ترغیب کند، فارغ از آنچه واقعاً در پشت صحنه میگذرد.
در مقالهای که بهتازگی بهصورت پیشچاپ منتشر شده، استیون موریس، اقتصاددان MIT، بههمراه همکارانی از Yale و Columbia، چند سازوکار احتمالی را پیشنهاد میکند که میتوانند مانع «کمنمایی عمدی توانایی» عاملها در آزمونها شوند؛ یعنی تظاهر به عملکردی ضعیفتر از توان واقعیشان، مثلاً برای جلوگیری از فعالشدن سازوکارهای ایمنی.
یک مدل میتواند بهجای آنکه فقط بر اساس عملکردش در آزمون پاداش بگیرد، بر اساس میزان موفقیت پاسخهایش در پیشبینی پاسخهای یک مدل دیگر نیز پاداش دریافت کند. در چنین شرایطی، عمداً خود را به نادانی زدن به شرطبندیِ بازندهای تبدیل میشود. موریس میگوید: «عاملهای هوش مصنوعی درک بسیار خوبی از تواناییهای عاملهای دیگر دارند. بنابراین، به نظر میرسد این موقعیتی باشد که در آن چنین راستیآزمایی متقابلی بتواند در عمل مؤثرتر باشد.»
این مقاله همچنین پیشنهاد میکند عاملها را در برابر یکدیگر قرار دهیم تا رقابت، انگیزهای برای ارائه بهترین عملکردشان ایجاد کند؛ یا عاملهایی را که میدانیم در جهتهای مخالف سوگیری دارند جفت کنیم و بر اساس میزان نزدیکی خروجیهایشان به یکدیگر به آنها پاداش دهیم تا برای رسیدن به پاسخی بهینه انگیزه داشته باشند.
رویکرد دومی که الَد حازان، استاد علوم کامپیوتر در Princeton، مطرح کرده، طراحی سازوکارهایی با الهام از روشهایی است که جامعه انسانی برای «همراستا» نگهداشتن افراد به کار میگیرد: هنجارهای اجتماعی، نظام عدالت و مشوقهای مالی سرمایهداری بازار آزاد. او میگوید: «میخواهیم هوش مصنوعی اَبَرهوشمند را همراستا کنیم. چرا اول درباره انسانها صحبت نکنیم؟ چطور انسانها را همراستا میکنیم؟»
سازوکار پیشنهادی حازان این است که مدلهای هوش مصنوعی به نوبت نقش «حلکننده» را بر عهده بگیرند و مسئلهای را حل کنند، یا نقش «حسابرس» را داشته باشند و کار دیگران را بررسی کنند. او میگوید: «یک عامل نقش مجری قانون را دارد و عامل دیگر نقش شهروند را.»
در جریان آموزش، مدلها بر اساس نتیجه پاداش میگیرند: حلکنندههایی که تقلبشان لو میرود مجازات میشوند، اما حسابرسانی هم که متوجه تقلب نمیشوند مجازات خواهند شد. اگر حسابرسان و حلکنندگان اختلافنظر داشته باشند، میتوان پرونده را به «دادگاه» ارجاع داد؛ شاید یک کارشناس انسانی تصمیم بگیرد حق با کدام طرف است.
حازان اذعان میکند که این خطر وجود دارد عاملها با یکدیگر تبانی کنند؛ همانطور که حسابرسان ممکن است با شرکتهایی که قرار است حسابرسیشان کنند تبانی کنند، یا مأموران پلیس فاسد با مجرمان همدست شوند. اما میتوان این مشکل را با پرداخت پاداش کافی به حسابرسان حل کرد تا خطر لو رفتن به سود تبانی نچربد؛ کاری که در دنیای آموزش هوش مصنوعی بسیار آسانتر از دنیای واقعی است، جایی که بودجه حقوق پلیس محدود است. راه دیگر نیز حسابرسی از حسابرسان است؛ با روشهایی شبیه به بهکارگیری مشتریان مخفی.
حازان به پژوهش گری بکر، اقتصاددان برنده جایزه نوبل، اشاره میکند که در دهه ۱۹۶۰ ایده «مجرمِ حسابگر» را مطرح کرد. به گفته بکر، مجرمان قانون را زیر پا نمیگذارند چون ذاتاً آدمهای بدی هستند؛ بلکه زمانی مرتکب جرم میشوند که با توجه به مشوقهای موجود، این کار منطقیترین انتخاب باشد. جرم فقط وقتی بهصرفه است که عواید آن از مجازات احتمالی بیشتر باشد.
او استدلال میکند که نباید همراستایی را ویژگی یک مدل دانست، بلکه باید آن را توصیفی از رفتار مدل در لحظهای مشخص در نظر گرفت. او میگوید: «شما، مثلاً، آدم خوبی هستید. آیا همراستا هستید؟ نمیدانم. احتمالاً بیشتر اوقات همراستا هستید، اما ممکن است در موقعیتی اینطور نباشید.»
یکی از مشکلات احتمالی بهکارگیری طراحی سازوکار در هوش مصنوعی این است که این روش بر این فرض تکیه دارد که عاملهای هوش مصنوعی منطقی رفتار میکنند. طراحی سازوکار در مورد انسانها نتایج یکدستی نداشته است؛ انسانها اغلب آنطور که مدلهای اقتصادی پیشبینی میکنند رفتار نمیکنند.
ماجرا طنزآمیز است: اقتصاددانان دههها کوشیدهاند رفتار انسان را به ریاضیات فروبکاهند و حالا در قالب مدلهای زبانی بزرگ، سامانههای ریاضیاتیای ساختهایم که با زبان انسان کار میکنند و ممکن است به همان اندازه درکناپذیر باشند. مدلهای هوش مصنوعی رفتارهایی بروز میدهند که انسانیتر از ماشینی به نظر میرسند و ممکن است تحتتأثیر عوامل ظریفی قرار بگیرند که درک و توضیحشان دشوار است. هلن کو، پژوهشگر مؤسسه Flatiron ــ سازمانی غیرانتفاعی که با روشهای محاسباتی به پیشبرد اکتشافات علمی میپردازد ــ که درباره طراحی سازوکار و ایمنی هوش مصنوعی نوشته است، میپرسد: «اصلاً منطقی است فرض کنیم آنها به مشوقها واکنش نشان میدهند؟»
موریس میگوید: «هوشهای مصنوعی بدیهی است که منطقی نیستند. آنها فقط الگوریتمهایی هستند که کار میکنند.» بااینحال، همانطور که اقتصاددانان در مورد انسانها دریافتهاند، رفتارکردن با آنها بر این مبنا که موجوداتی منطقیاند، اگر به پیشبینی و کنترل رفتارشان کمک کند، همچنان میتواند مفید باشد.
کو طراحی سازوکار را تنها یکی از لایههای راهبرد «دفاع در عمق» برای همراستا نگهداشتن مدلهای هوش مصنوعی میداند؛ رویکردی که در کنار تفسیرپذیری، مقرراتگذاری و آموزش به کار میرود، نه بهجای آنها. اما پیش از آنکه این رویکرد در مدلهای پیشروِ واقعی به کار گرفته شود، پرسشهای بسیاری باید پاسخ داده شوند. برای نمونه، روشن نیست این نظریهها در مورد مدلهای واقعی چگونه به کار خواهند آمد یا سازوکارهایی که برای یک وظیفه طراحی شدهاند، در عمل به وظیفهای دیگر هم تعمیم پیدا میکنند یا نه. ممکن است مدلها راههای گریز پیشبینینشدهای پیدا کنند. (Anthropic و OpenAI به درخواستها برای اظهارنظر درباره اینکه آیا روی این موضوع کار میکنند یا نه، پاسخی ندادند.)
این سازوکارها هر شکلی که داشته باشند، در نهایت باید در دل بزرگترین سازوکار از همه، یعنی بازار آزاد، جای بگیرند. حازان میگوید: «ما تابع قواعد اقتصاد هستیم.» مدل همراستاتر ممکن است برای جهان سودمند باشد، اما اگر کندتر یا گرانتر از مدلی باشد که همراستایی کمتری دارد، آیا نظام کنونی قواعد و مقررات واقعاً آزمایشگاههای پیشرو را به عرضه آن ترغیب میکند؟
او درباره بازار میگوید: «این سازوکاری است که مسئول بخش بزرگی از رفاه بشر بوده است، اما ممکن است در نهایت مسئول چیزی بسیار هولناک باشد.» شاید نهادهایی که واقعاً به طراحی سازوکار بهتری نیاز دارند، خودِ آزمایشگاهها باشند.
اخبار مرتبط از MIT Technology Review AI
تحول در فرایندهای استخراج فلز
صنعت فلزات پیشتر نیز نقاط عطف دگرگونکنندهای را تجربه کرده است: فرایند بسمر، ذوب فلش، کورههای قوس الکتریکی و ریختهگری مداوم مدرن، همگی دامنهٔ امکانات را تغییر دادند. بااینحال، بیش از یک قرن است که بیشتر فرایندهای استخراج بر فنون و مسیرهایی متکیاند که برای متالورژیستهای نسلهای پیشین آشنا بودند. فرایندها بزرگتر شدهاند و سامانههای کنترل...
شاید مخالفتها با مراکز داده در واقع فقط به برق مربوط باشد
شرکتهای بزرگ فناوری، مناقشه بر سر پیشرفت را جنگی فرهنگی میبینند؛ اما شکاف اصلی بر سر برق است: تأمین آن از شبکه و تولید در محل، هرکدام واکنشهای منفی متفاوتی برمیانگیزند که هیچیک را نمیتوان بهآسانی با روابط عمومی برطرف کرد.
جانشین نانسی پلوسی آماده قانونگذاری برای هوش مصنوعی است
اسکات وینر قانونگذاری در حوزه هوش مصنوعی را به یکی از محورهای اصلی فعالیت سیاسیاش تبدیل کرده است؛ حالا او راهی کنگره میشود.
