هزینه پنهان ذخیرهسازی هوش مصنوعی: آنچه فرایند استنتاج بر جای میگذارد
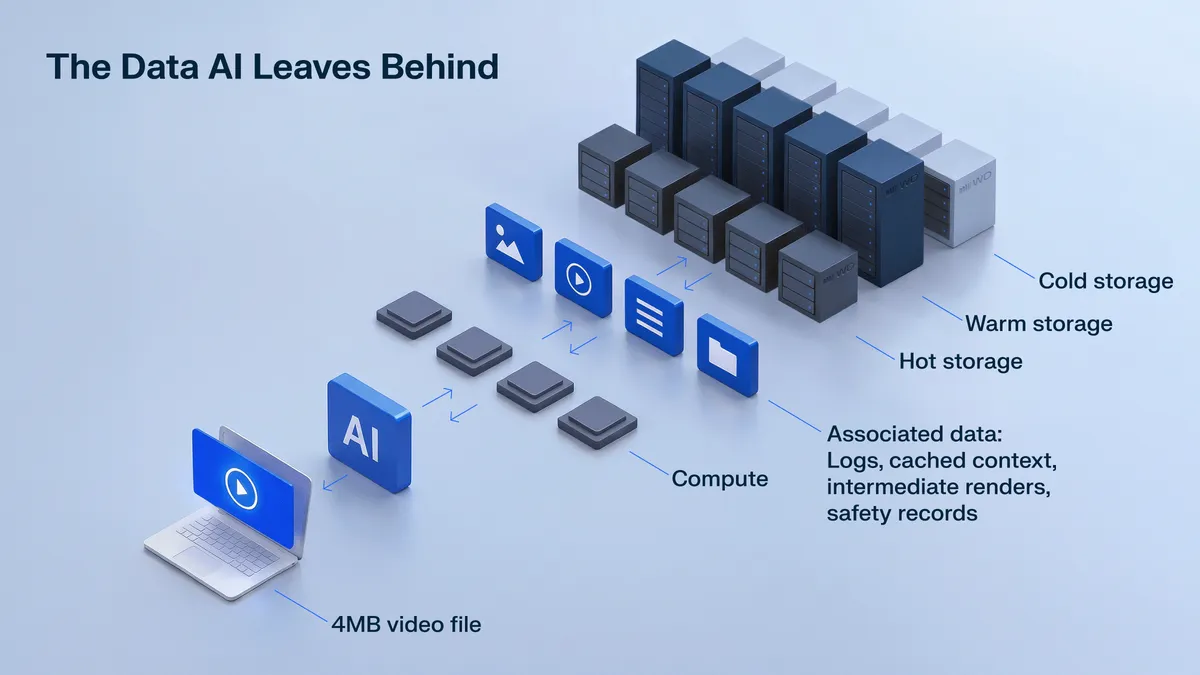
اگر از بیشتر مدیران ارشد بخواهید هزینه هوش مصنوعی را تصور کنند، احتمالاً به یاد GPUها میافتند: رکهایی از شتابدهندهها که به گیگاوات برق نیاز دارند و صف انتظار برای تراشه. اما این تصویر یک نکته را نادیده میگیرد: هزینههای ذخیرهسازی داده. پس از پاسخدادن یک مدل، چه اتفاقی برای دادهها میافتد؟ بخش زیادی از دادههای پشتیبان که از میلیاردها prompt، تصویر و ویدئوی روزانه تولید میشوند، به...
اگر از بیشتر مدیران بپرسید هزینه هوش مصنوعی را چطور تصور میکنند، احتمالاً به یاد GPUها میافتند: رکهایی از شتابدهندهها که گیگاواتها برق مصرف میکنند و صف انتظار برای دریافت تراشه. اما این تصویر یک بخش مهم را نادیده میگیرد: هزینه ذخیرهسازی داده.

بعد از پاسخدادن مدل، چه بر سر دادهها میآید؟ بخش زیادی از دادههای پشتیبانِ تولیدشده—از میلیاردها پرامپت، تصویر و ویدئوی روزانه—باید ذخیره شود. بااینحال، برنامهریزی برای هزینه ذخیرهسازی داده یکی از دشوارترین بخشهای برنامهریزی زیرساخت است و اغلب در برنامهریزی اولیه زیرساخت هوش مصنوعی نادیده گرفته میشود.
با افزایش مقیاس استنتاج، حجم دادهها هم رشد میکند
گفتوگوها درباره زیرساخت هوش مصنوعی بهطور سنتی بر فرایند پردازشمحورِ آموزش مدل متمرکز بودهاند. آموزش فرایندی محدود است: یک نوبت اجرا آغاز میشود، منابع پردازشی را مصرف میکند و پایان مییابد. اما استنتاج بهطور پیوسته انجام میشود؛ هر بار که مدلی به یک پرامپت پاسخ میدهد. این تفاوت برای برنامهریزی زیرساخت اهمیت دارد: اجرای آموزش پروژهای است که میتوان برایش بودجه تعیین کرد و پس از پایان کنار گذاشت. اما استنتاج پایان نمییابد و هر درخواست استنتاج، دادهای از خود بهجا میگذارد.
ویدئوی تولیدشده با هوش مصنوعی را در نظر بگیرید. در این نوع بارکاری، هزینههای پشتیبان میتواند چشمگیر باشد. WD بر اساس اندازهگیریهای داخلی خود دریافت که یک کلیپ 8 ثانیهای (که بهصورت فایلی با وضوح 720p و حجم 3.97MB به کاربر تحویل داده میشود)، بیش از 500MB داده مرتبط در بخش پشتیبان بر جا میگذارد؛ از جمله گزارشها، زمینه ذخیرهشده در حافظه نهان، رندرهای فوری، نسخههای پشتیبان و سوابق ایمنی. این مقدار 130 برابر حجم فایل خروجیای است که کاربر میبیند. اگر این وضعیت را به سازمانی تعمیم دهیم که ویدئوهای طولانیتر و با وضوح بالاتر تولید میکند، حجم دادههای پشتیبان برای هر کلیپ به صدها گیگابایت میرسد.
حجم این دادههای پشتیبان بهسرعت در حال افزایش است. McKinsey پیشبینی میکند تقاضا برای استنتاج هوش مصنوعی تا سال 2030 با نرخ رشد مرکب سالانه 35 درصد افزایش یابد؛ درحالیکه این نرخ برای آموزش 22 درصد است. در پایان این دهه، استنتاج بیش از 40 درصد از کل تقاضای مراکز داده را تشکیل خواهد داد.
در گزارش جهانی اخیر IDC با حمایت مالی WD که در آن از 763 تصمیمگیرنده حوزه فناوری اطلاعات و کسبوکار نظرسنجی شده، نزدیک به 95 درصد پاسخدهندگان گفتهاند حجم دادههایشان در 12 ماه گذشته بهدلیل هوش مصنوعی مولد افزایش یافته است. حدود 61 درصد نیز از رشد 25 درصدی یا بیشتر خبر دادهاند.
یکی از مدیران ارشد محصول در یک ارائهدهنده خدمات ابری ابرمقیاس که در این گزارش نقلقول شده، گفت: «میتوان ذخیرهسازی بیشتر را راهی برای بهینهسازی و مشغول نگهداشتن GPUها دانست. بزرگترین چالش این است که مطمئن شویم GPUها بیکار نمیمانند و منتظر رسیدن داده نیستند؛ چند ساعت بیکاری GPU خیلی سریع هزینه زیادی به بار میآورد.» اگر این موضوع را به زبان هزینه بیان کنیم: وقتی هزینه ذخیرهسازی شما سالبهسال 25 درصد رشد میکند، اما بودجه پردازش طبق روند چرخهایِ قابلپیشبینیتری افزایش مییابد، هزینه ذخیرهسازی در نهایت از ردیف بودجهای پیشی میگیرد که بیشترین توجه را به خود جلب میکند.
هماهنگکردن ذخیرهسازی با چرخه عمر دادههای هوش مصنوعی
تقاضا برای پردازش با چرخههای آموزش، عرضه محصولات و نوسازی سختافزار بالا و پایین میشود. اما وقتی تقاضا برای پردازش کاهش مییابد، حجم دادههای نگهداریشده به همان نسبت کم نمیشود. گزارشهای مدل، خروجیهای مصنوعی، نتایج استنتاج و موارد دیگر همچنان انباشته میشوند و سازمانها حجم بیشتری از این دادهها را برای مدت طولانیتری نگه میدارند.
این موضوع نقش دادههای نگهداریشده را تغییر میدهد. اطلاعاتی که زمانی به آرشیو منتقل میشدند و بهندرت مورد استفاده قرار میگرفتند، حالا میتوانند به ورودی بارکاریهای آینده هوش مصنوعی تبدیل شوند. با نگهداری، بازیابی و استفاده مجدد از دادههای بیشتر، ذخیرهسازی باید نهتنها از ظرفیت روبهرشد، بلکه از دسترسی هرچه پویاتر به دادهها نیز پشتیبانی کند. همان نظرسنجی WD-IDC نشان داد که 96 درصد پاسخدهندگان انتظار دارند برای پشتیبانی از استنتاج یا تولید افزوده بر بازیابی (RAG)، بازیابی سریعتر دادهها از آرشیو ضرورت پیدا کند.
بارکاریهای هوش مصنوعی هم به کارایی و هم به ظرفیت نیاز دارند و فناوریهای مختلف در بخشهای گوناگون چرخه عمر داده، نیازهای متفاوتی را برآورده میکنند. برای حجم عظیم دادههایی که باید نگهداری و دوباره به آنها مراجعه شود، HDDها زیرساختی مقرونبهصرفه و پُرظرفیت فراهم میکنند و از نظر هزینه بهازای هر ترابایت، مزیت چشمگیری دارند.
این موضوع چه معنایی برای بودجهبندی هوش مصنوعی دارد؟
برای مدیر مالی ارشد یا مدیر ارشد اطلاعات، این یعنی ممکن است دامنه «هزینههای زیرساخت هوش مصنوعی» بیش از حد به پردازش محدود شده باشد. مدلی که هنگام بارگذاری داده بیکار میماند، تقریباً بهاندازه مدلی هزینه دارد که بهدلیل نبود GPU بیکار است. اما گلوگاه ذخیرهسازی تا زمانی که به مشکل تبدیل نشود پنهان میماند و خود را در هزینههای عملیاتی و تأخیر در بازیابی نشان میدهد، نه در ردیف هزینه سرمایهای (CapEx) کنار شتابدهندهها.
خردهفروشی را در نظر بگیرید که برای فهرست محصولاتش ویدئوهای هوش مصنوعی تولید میکند، یا شرکت بیمهای که برای تسریع ارزیابی درخواستهای بیمه، اسناد خسارت را از مسیر یک خط لوله RAG عبور میدهد. در هر دو مورد، هزینه پردازش مقداری مشخص و بودجهبندیشده است: نرخ هر تولید یا هر پرسوجو که واحد مالی میتواند آن را پیشبینی کند. اما هزینه ذخیرهسازی متفاوت است: با تولید هر ویدئو و پردازش هر درخواست خسارت روی هم انباشته میشود، زیرا پس از پایان کار، هیچیک از دادههای پشتیبان ناپدید نمیشود.
تیمی که بودجه هوش مصنوعی را با این فرض میبندد که «هزینه پردازش بهعلاوه مبلغی ناچیز برای ذخیرهسازی» کافی است، ممکن است 12 تا 18 ماه بعد متوجه شود آن مبلغ ناچیز به بخش قابلتوجهی از کل هزینه برنامه تبدیل شده است؛ درست در زمانی که مدیران ارشد تصمیم میگیرند دامنه برنامه را گسترش دهند یا نه.
ایجاد ظرفیت با مقیاسپذیری اقتصادی
رسیدگی به این چالش با معماری آغاز میشود. راهبردهای ذخیرهسازی معمولاً برای کارایی گرانقیمتِ لایه داغ طراحی میشوند؛ لایهای برای دادههایی که پیوسته و بیدرنگ به آنها دسترسی پیدا میشود. درحالیکه بیشتر دادههای هوش مصنوعی، از نظر حجم، در لایههای گرم، خنک و سردِ پاییندست انباشته میشوند.
سازمانها به ظرفیتی نیاز دارند که از نظر اقتصادی مقیاسپذیر باشد: زیرساختی که برای کل چرخه عمر دادههای هوش مصنوعی طراحی شده و با ماندگارشدن، انباشتهشدن و استفاده مجدد هرچه بیشتر از دادهها، میان کارایی، ظرفیت، مصرف برق، اطمینانپذیری و کل هزینه مالکیت توازن برقرار کند. این یعنی آرشیوهایی را که زمانی دستنخورده باقی میماندند، داراییهای فعالی برای RAG و استنتاج بدانیم و سیاستهای نگهداری داده را بر اساس ارزش راهبردیِ فزاینده آنها تعیین کنیم، نه هزینه اولیه ذخیرهسازیشان. همچنین باید در نظر داشت که تصمیمهای مربوط به ذخیرهسازی در مقیاس ناوگان تجهیزات معنا پیدا میکنند، نه در مقیاس یک درایو منفرد.
چنین زیرساختی به لایههای ذخیرهسازی نیاز دارد؛ لایههایی که مصرف برق هرکدام، اطمینانپذیری، تراکم و کارایی عملیاتیشان تعیین میکند آیا با افزایش ظرفیت، سامانه از نظر اقتصادی پایدار میماند یا نه.
در ارزیابی بودجه زیرساخت هوش مصنوعی سازمانتان، سه پرسش را مطرح کنید:
- سیاست ما برای نگهداری محتوای تولیدشده با هوش مصنوعی چیست و چه کسی آن را تعیین میکند؟
- خرید تجهیزات ذخیرهسازی ما بر اساس نیازهای کارایی در زمان آموزش انجام میشود یا بر مبنای چرخه عمر واقعی دادههایی که تولید میکنیم؟
- اگر استفاده ما از هوش مصنوعی سال آینده دو برابر شود، هزینه ذخیرهسازیمان هم دو برابر خواهد شد یا حتی بیشتر؟
بیشتر سازمانها نمیتوانند با اطمینان به هر سه پرسش پاسخ دهند. این شکافی است که باید پیش از چرخه بودجهبندی بعدی برطرف شود، نه پس از آن.
این محتوا را WD تهیه کرده است. این مطلب را اعضای تحریریه MIT Technology Review ننوشتهاند.
اخبار مرتبط از MIT Technology Review AI
تحول در فرایندهای استخراج فلز
صنعت فلزات پیشتر نیز نقاط عطف دگرگونکنندهای را تجربه کرده است: فرایند بسمر، ذوب فلش، کورههای قوس الکتریکی و ریختهگری مداوم مدرن، همگی دامنهٔ امکانات را تغییر دادند. بااینحال، بیش از یک قرن است که بیشتر فرایندهای استخراج بر فنون و مسیرهایی متکیاند که برای متالورژیستهای نسلهای پیشین آشنا بودند. فرایندها بزرگتر شدهاند و سامانههای کنترل...
شاید مخالفتها با مراکز داده در واقع فقط به برق مربوط باشد
شرکتهای بزرگ فناوری، مناقشه بر سر پیشرفت را جنگی فرهنگی میبینند؛ اما شکاف اصلی بر سر برق است: تأمین آن از شبکه و تولید در محل، هرکدام واکنشهای منفی متفاوتی برمیانگیزند که هیچیک را نمیتوان بهآسانی با روابط عمومی برطرف کرد.
جانشین نانسی پلوسی آماده قانونگذاری برای هوش مصنوعی است
اسکات وینر قانونگذاری در حوزه هوش مصنوعی را به یکی از محورهای اصلی فعالیت سیاسیاش تبدیل کرده است؛ حالا او راهی کنگره میشود.
