فراتر از متن و تصویر؛ مدل هوش مصنوعی AudioX مرزهای تولید صدا را جابهجا میکند
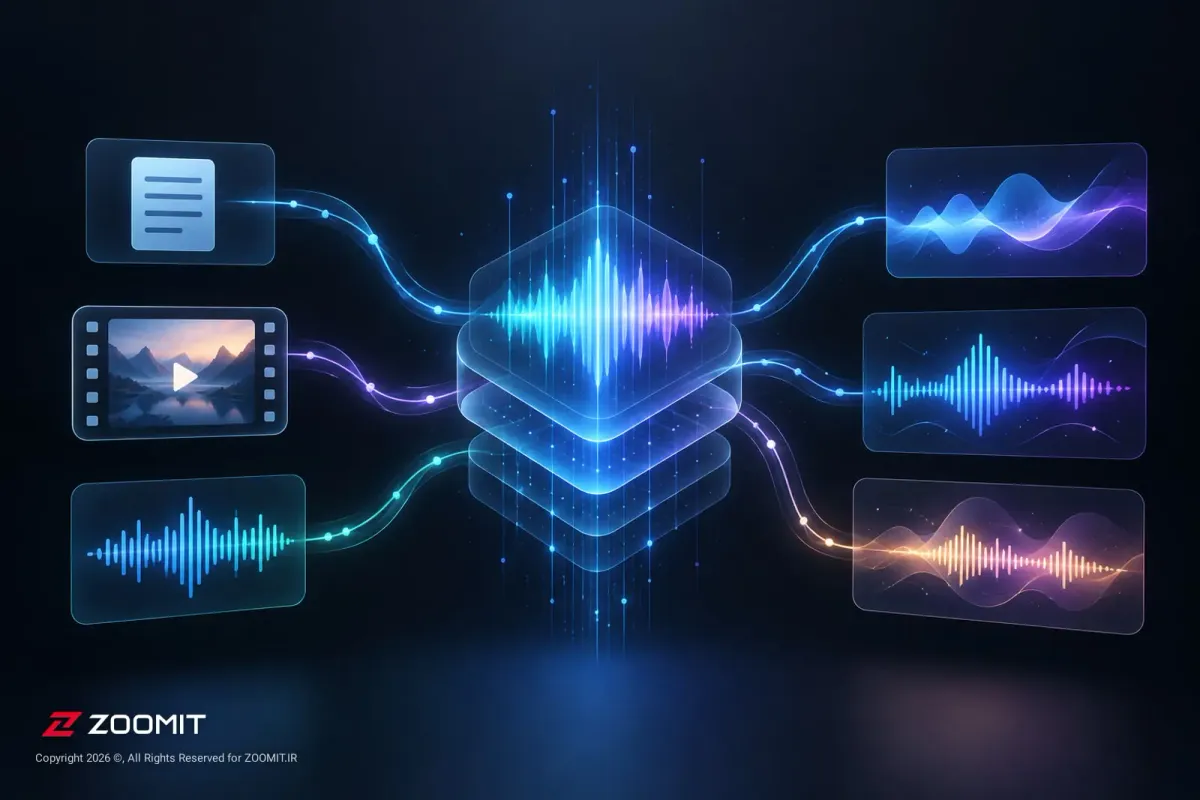
پژوهشگران حوزهی هوش مصنوعی چارچوب چندوجهی جدیدی را برای تولید صدا و موسیقی از متن، ویدیو و فایلهای صوتی معرفی کردند.
پژوهشگران حوزهی هوش مصنوعی چارچوب چندوجهی جدیدی را برای تولید صدا و موسیقی از متن، ویدیو و فایلهای صوتی معرفی کردند.
محققان هوش مصنوعی چارچوب یکپارچهی نوینی به نام AudioX توسعه دادهاند که توانایی تولید صدا و موسیقی را از ورودیهای گوناگون نظیر متن، ویدیو و سیگنالهای صوتی در یک سامانهی واحد فراهم میکند.
توسعهدهندگان در این پروژه ماژول جدیدی با عنوان ادغام تطبیقی چندوجهی یا MAF طراحی کردهاند تا ترکیب ورودیهای نامتجانس را بهبود بخشند و هماهنگی میانوجهی دقیقتری ایجاد کنند. پژوهشگران برای آموزش این مدل، دیتاستهای جامعی متشکل از بیش از ۷ میلیون نمونه موسوم به IF-caps گردآوری و منتشر کردهاند.
پروژهی مذکور در پلتفرم هاگینگ فیس در قالب سه نسخهی مجزا شامل مدل پایهی AudioX، نسخهی مجهز به ماژول تلفیق AudioX-MAF و نسخهی پیشرفتهتر AudioX-MAF-MMDiT منتشر شده است. ارزیابیهای اولیه از عملکرد قدرتمند این ساختار در وظایف متن به صدا، متن به موسیقی و همچنین پیروی از دستورهای پیچیده حکایت دارد.
دسترسی به کدهای منبع، وزنهای مدل و دموی تعاملی برای پژوهشگران مهیا است. اجرای آفلاین این مدل به محیط پایتون نسخهی ۳٫۸ و بالاتر بههمراه ابزارهایی نظیر FFmpeg و کارت گرافیک سازگار با محاسبات هوش مصنوعی نیاز دارد.
اخبار مرتبط از زومیت AI
هوش مصنوعی جدید گوگل برای کشف راز بیماریها معرفی شد
گوگل از آلفاژنوم ۲ رونمایی کرد؛ هوش مصنوعی جدیدی که میتواند به شناخت ریشهی بیماریها کمک کند.
در تصمیمگیری مشکل دارید؟ ۲۵۰ میلیثانیه از زمانتان را به هوش مصنوعی جدید گوگل بدهید!
گوگل مدل Gemini Decision 1 را معرفی کرد؛ هوش مصنوعی تازهای که میتواند تا هزار سؤال دربارهی متن، تصویر و ویدیو را به سرعت ارزیابی کند.
اپل و سامسونگ برای رقابت با هواوی به هوش مصنوعی چینی روی آوردند
اپل و سامسونگ برای تداوم حضور در بازار چین، خدمات هوش مصنوعی خود را به غولهای فناوری آن کشور متکی کردهاند.
